JVM虚拟机 摘自王二的Java进阶之路
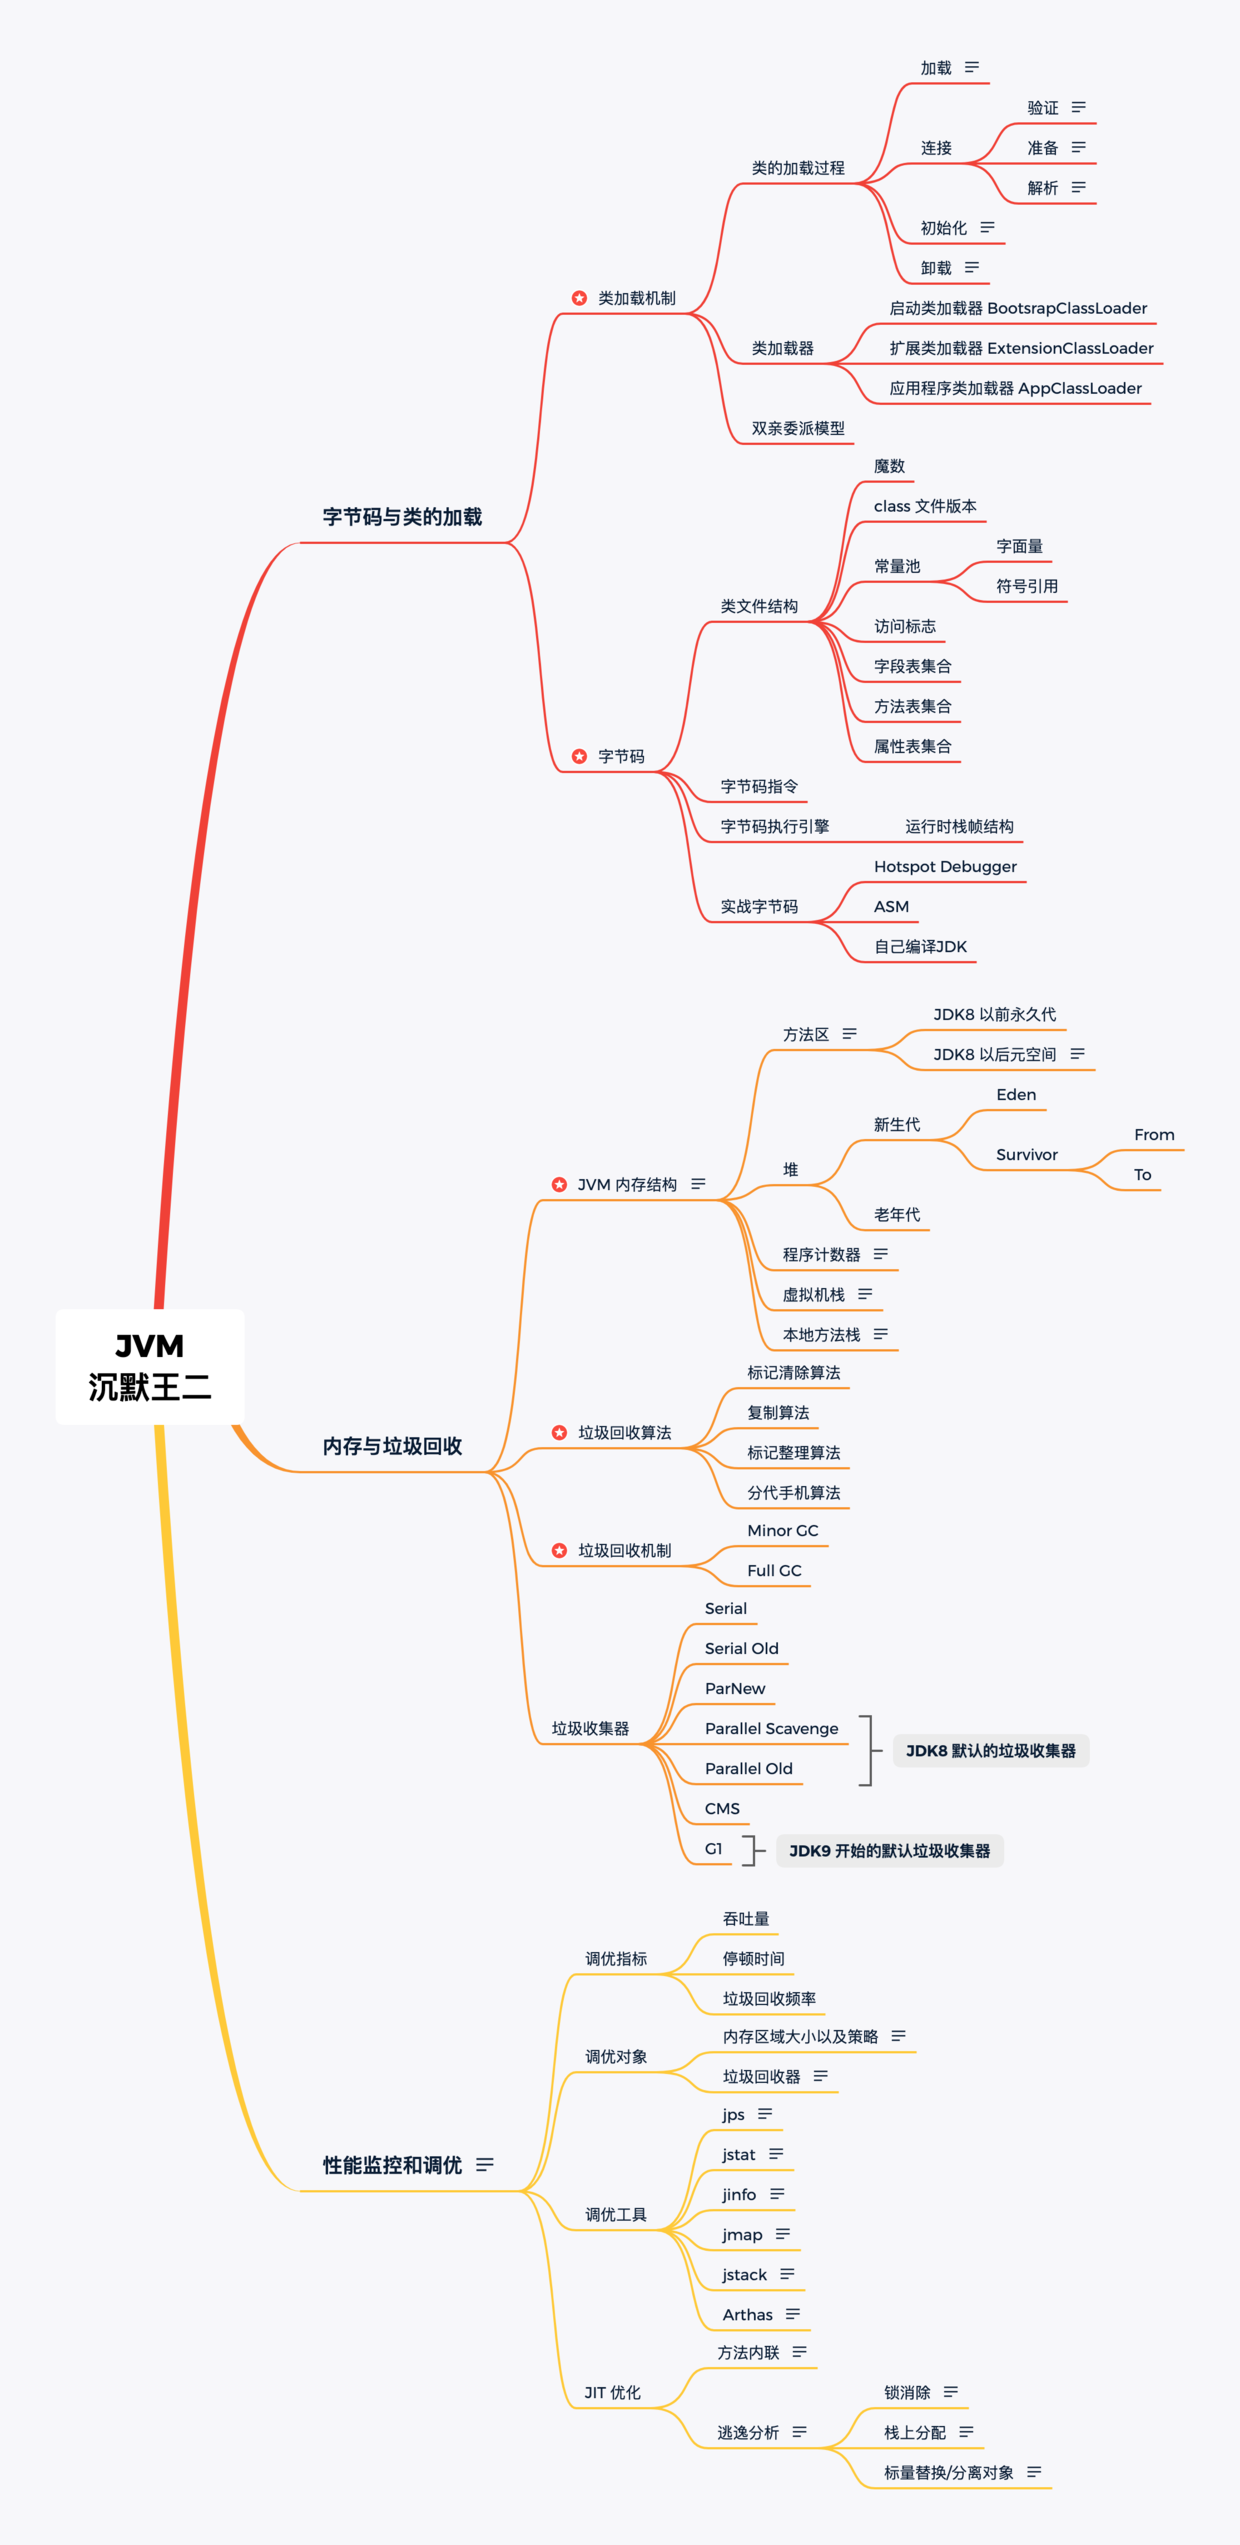
JVM简要介绍
在很久以前,Green项目组想要开发一种跨平台的程序架构,C++是不行的,因为C++在Windows下编译的,无法拿到Linux环境里直接运行。
但是有一个东西叫做直译器,也叫解释器,就是每跑一行代码就生成机器码,然后执行。像Python和Ruby就是直译器。
那么每个操作系统都装一个直译器不就解决了?
但是直译器有个缺点,就是没办法像编译器那样对一些热点代码进行优化,从而加速程序的运行。
那么怎么办?
结果是:编译器和直译器一起上!也就是Java的方式。
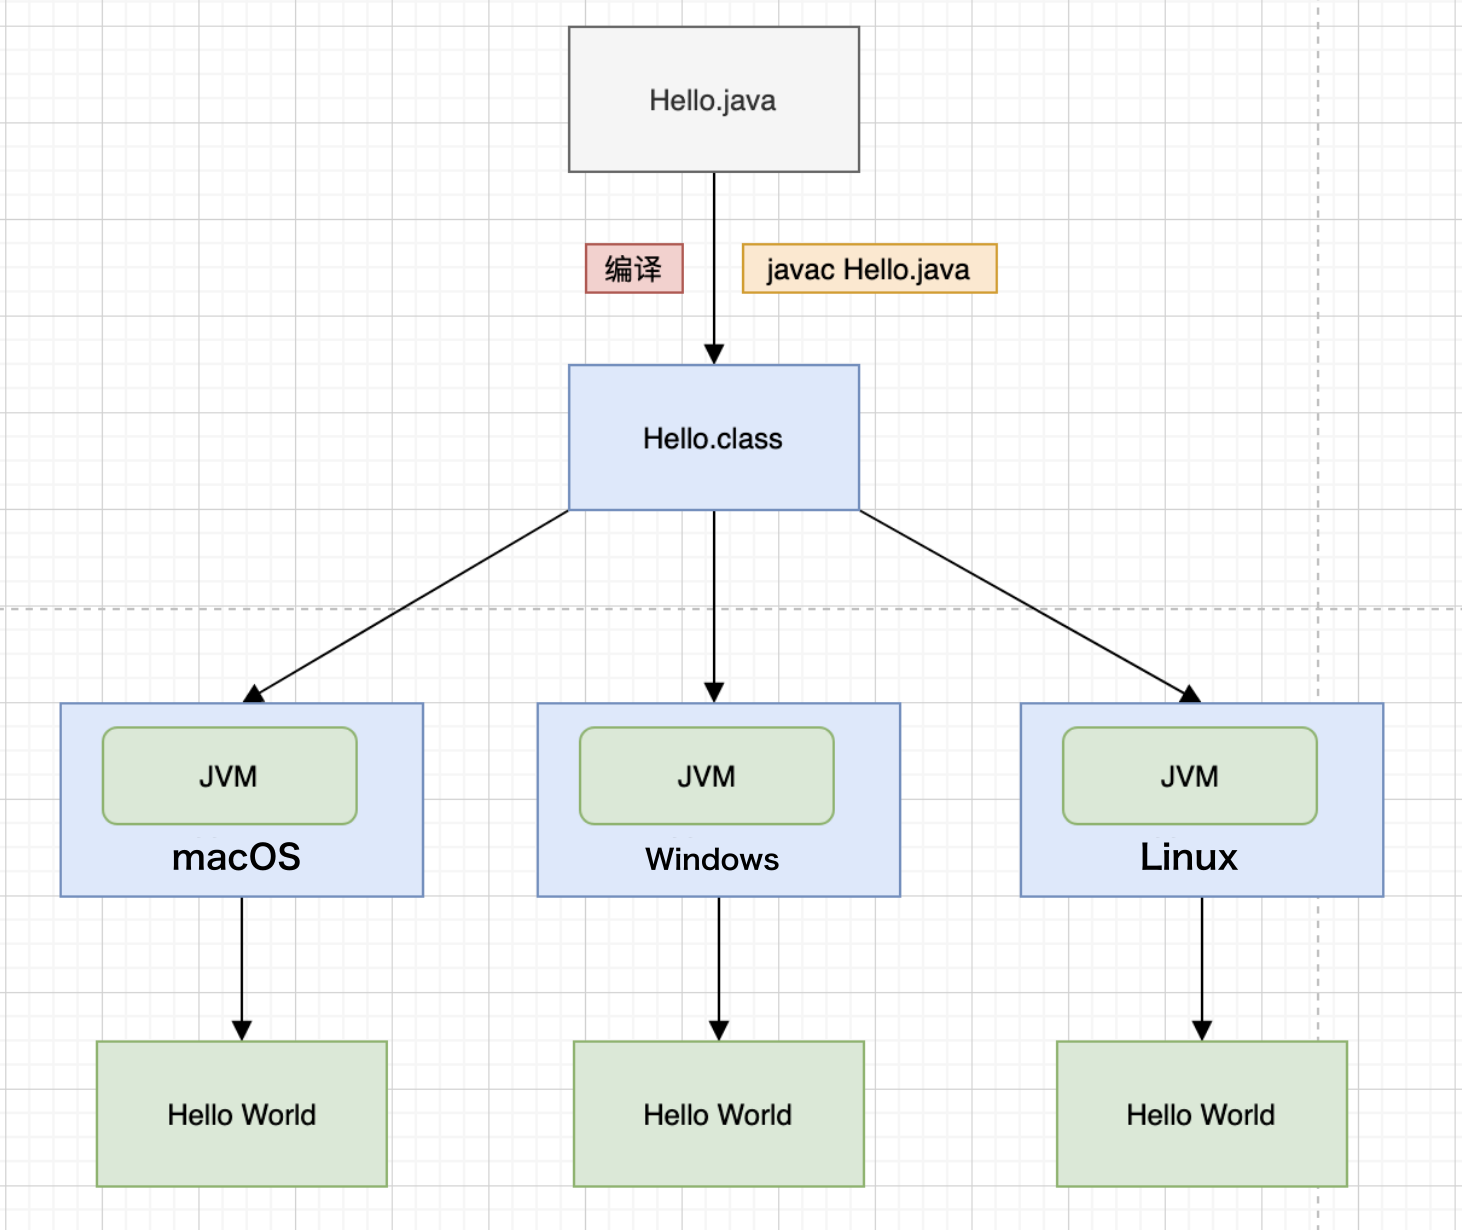
编译器负责把Java源代码编译成字节码,然后JVM负责把字节码转换成机器码。转换的时候,可以做一些压缩或者优化。通过JIT来完成,加速程序速度。
Java编译器跨平台的目的达到了,而且性能也得到了优化!唯一缺点应该是JVM占内存空间比较大。
热点代码探测,指的是,通过执行计数器找到最具有编译价值的代码,然后通知即时编译器以方法为单位进行编译,解释器就会直接把一整个方法的所有字节码翻译成机器码再执行。
这样的话效率提高很多。这个就是JIT技术。
JVM的组织架构
JVM可以大概分为三个部分:分别是类加载器、运行时数据区以及执行引擎。英文分别是Class Loader、Runtime Data Areas和Execution Engine。
类加载器
类加载器是最重要的,用来加载类文件。如果类文件加载失败,也就不会有运行时数据区和执行引擎。
类加载器负责把字节码文件加载到内存中。主要会经历加载->连接->实例化这三个阶段。
运行时数据区
JVM定义了Java程序运行其间需要用到的内存区域,简单来说,这块区域里面存放了字节码信息以及程序执行过程中的数据,垃圾收集器也会针对运行时数据区做对象回收。
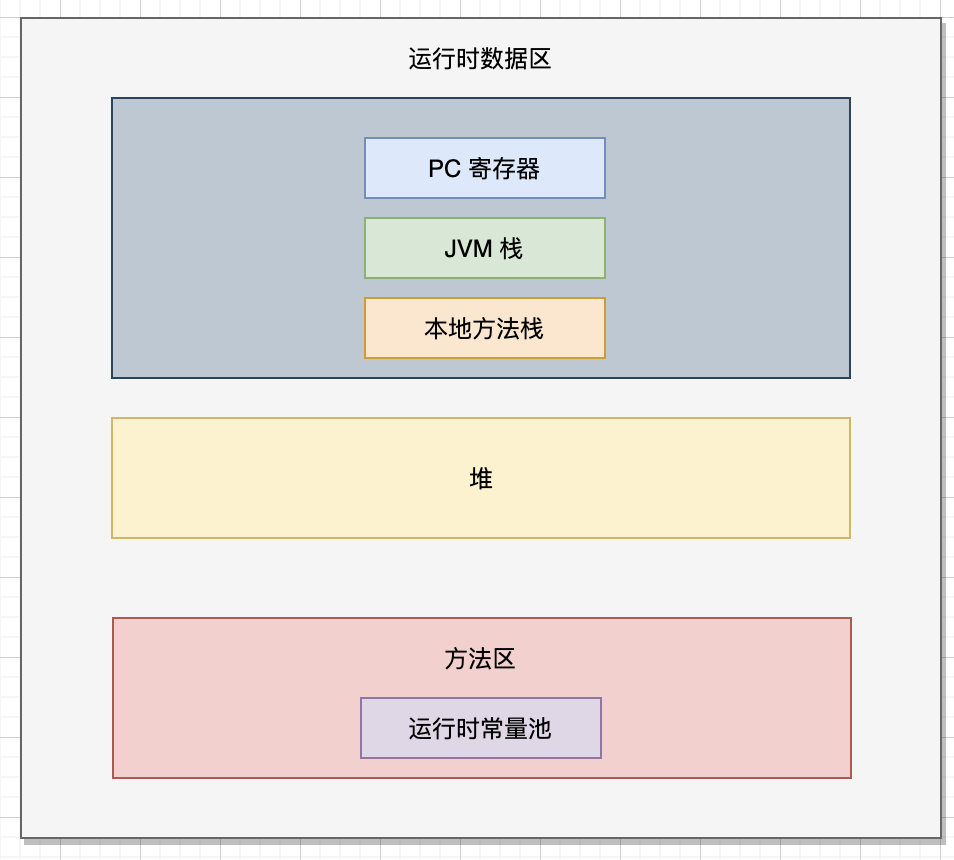
运行时数据其通常包括方法区、堆、本地方法栈、虚拟机栈和程序计数器五部分组成。
执行引擎
执行引擎主要用来干具体的事情。虚拟机和物理机都有执行代码的能力。区别在于,物理机的执行引擎是直接建立在操作系统层面,而虚拟机的执行引擎是由软件自行实现的,因此可以更多样化,能支持不被硬件直接支持的指令集格式。
执行引擎的任务就是把字节码指令解释、编译为对应平台上的本地机器指令才可以。充当了把高级语言翻译为机器语言的角色。
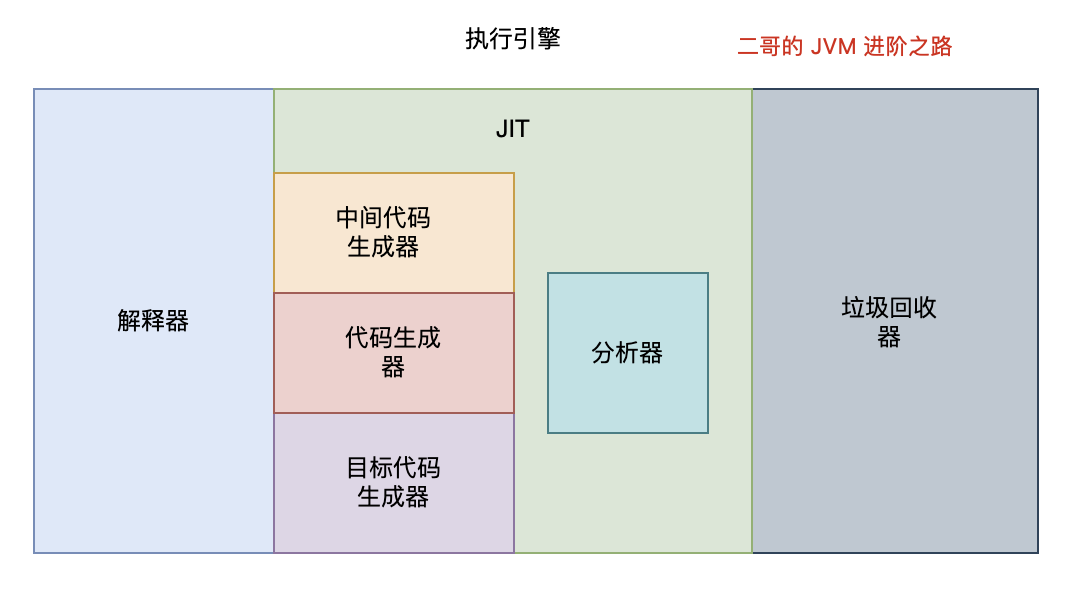
- 解释器:读取字节码,执行指令。但是是一行行地,跟python等语言一样。所以执行速度比较慢。
- 即时编译器:执行引擎先按照解释执行的方式来执行,慢慢地即时编译器会选择性地把一些热点代码编译成本地代码,执行本地代码速度比一条条解释执行速度快,因为本地代码是直接保存在缓存里的。
- 垃圾回收器:用来回收堆内存中的垃圾对象。
JVM如何运行Java代码?
当有了.class文件之后,JVM会先通过类加载器加载字节码文件,然后把字节码加载到JVM的运行时数据区,再通过执行引擎转化为机器码最终交给操作系统去执行。
如果虚拟机中的当前线程执行的是Java的普通方法,那么PC寄存器存储的是方法的第一条指令。当方法开始执行之后,PC寄存器存储的是下一个字节码指令的地址。
如果虚拟机中当前线程执行的是native方法,那么PC寄存器中的值为undefined。
如果遇到判断分支、循环等控制转移语句,PC寄存器会被置为目标字节码的地址。
除了PC寄存器外,字节码指令的执行流转还需要虚拟机栈参与。虚拟机栈的大致结构如下:
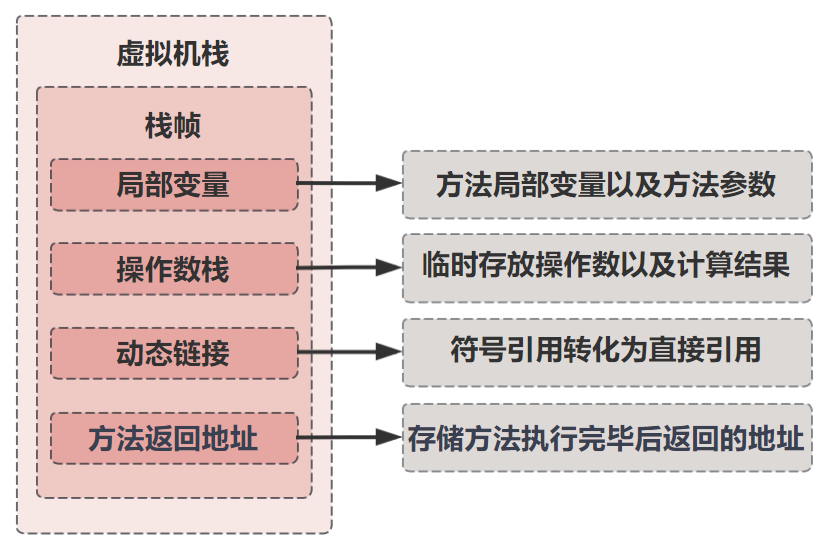
虚拟机栈操作的基本元素就是栈帧,栈帧主要包含了局部变量表、操作数栈、动态链接以及方法返回地址。栈是先进后出的数据结构。每个方法从调用到执行完成都对应一个栈帧的入栈和出栈。
Java的类加载机制
class文件开头有魔数“cafe babe”。这就是JVM识别.class的标志。
类加载过程
Java的类加载过程: 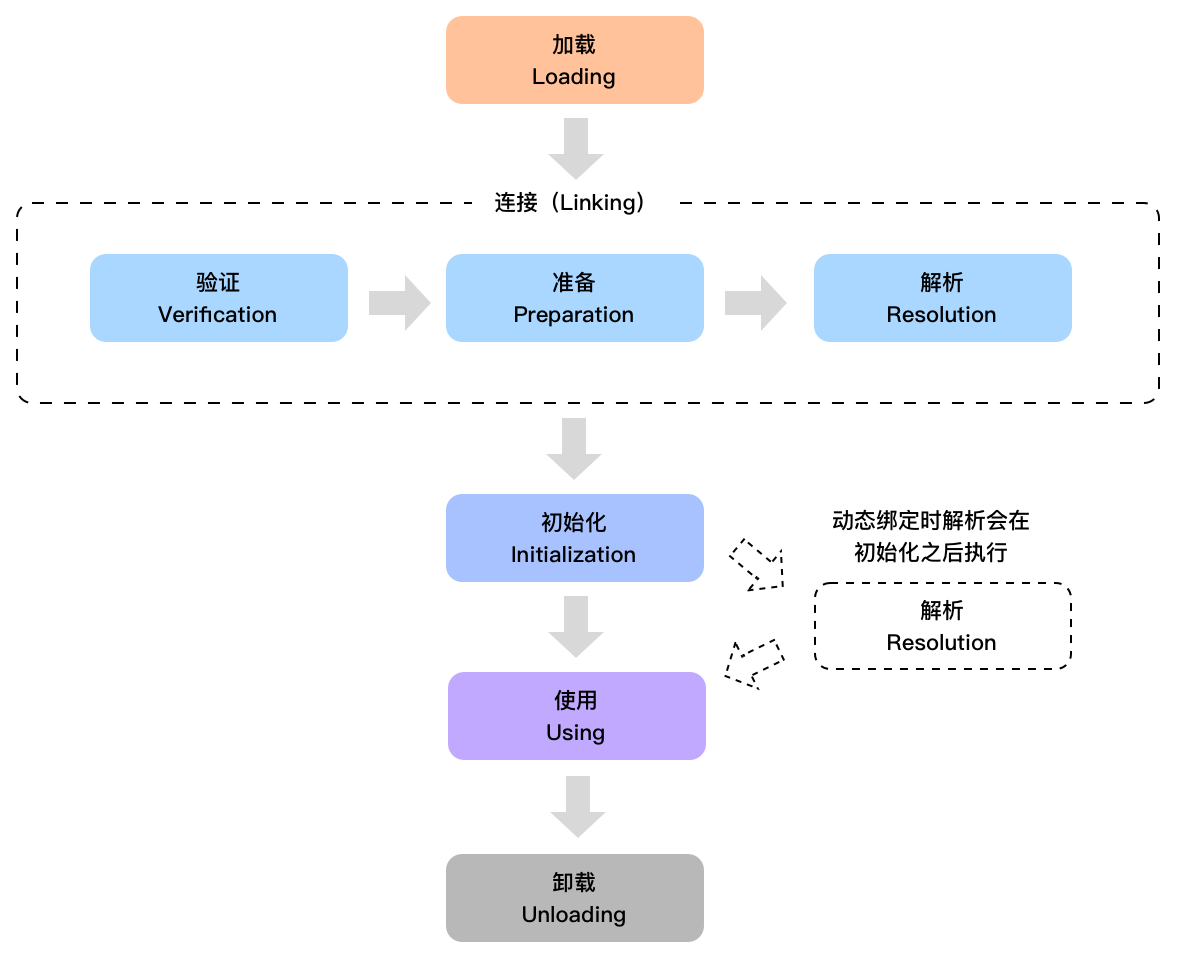
类从被加载到JVM开始,到卸载出内存,整个生命周期分为7个阶段,分别是加载、验证、准备、解析、初始化、使用和卸载。
其中、验证、准备、解析这三个阶段统称为链接。
除去使用和卸载,其他剩下的就是Java的类加载过程。
这5个顺序一般是顺序发生的,但是在动态绑定的情况下,解析阶段发生在初始化阶段之后。
Loading:加载阶段 JVM在这个阶段的目的是把字节码从不同的数据源(可能是class文件、可能是jar包、甚至网络)转换为二进制字节流加载到内存中,并生成一个代表该类的Class对象。
Verification:验证阶段 JVM会在这个阶段对二进制字节流进行校验,只有符合JVM字节码规范的才能被JVM正确执行。这个阶段是保证JVM安全的重要屏障,下面是一些主要的检查。
- 确保二进制字节流符合预期,比如是否是cafe babe开头
- 巴拉巴拉
Preparation:准备阶段 JVM会在这个阶段对类变量(注意是类的变量,也就是static的)分配内存并初始化,对应数据类型的默认初始值。
public String chenmo = "沉默";
public static String wanger = "王二";
public static final String cmower = "沉默王二";
比如上面的代码,在准备阶段,chenmo不会被分配内存,因为它是对象的变量,而wanger会被分配内存,但是默认值是null而不是“王二”。而cmower会被分配变量,并且它是static final修饰,也就不是类的变量而是常量了。因此它直接初始化值就等于“沉默王二”
- Resolution:解析阶段 该阶段将常量池中的符号引用转化为直接引用。 什么是符号引用,什么是直接引用?
符号引用,以一组符号来描述所引用的目标。因为在编译的时候,Java类肯定是不知道所引用的类的实际地址的。因此只能用符号引用来代替。比如com.Wanger类引用了com.Chenmo类。编译时Wanger类并不知道Chenmo类的实际内存地址,因此都是用符号com.Chenmo。
直接引用,通过对符号引用进行解析,找到引用的实际内存地址。
符号引用:
- 定义:包含了类、字段、方法、接口等多种符号的全限定名
- 特点:在编译时生成、存储在编译后的字节码的常量池中
- 独立性:不依赖于具体的内存地址,有更好的灵活性
直接引用:
- 定义:直接指向目标的指针、相对偏移量或一个间接定位到目标的句柄
- 特点:在运行时生成
- 效率:因为是直接指向内存地址或者偏移量,所以直接引用访问对象的效率较高。
如果不涉及动态加载,那么解析结果可以缓存,避免多次解析同一个符号。这个情况下,解析发生在初始化之前。
但是如果用了动态加载,前面解析过的符号,后面再次解析,结果可能会不同。而动态加载时,解析过程发生在程序执行到这条指令的时候。因此此时,动态加载时,解析会发生在初始化之后。
解析阶段的工作:解析类、接口、类方法、接口方法、字段。
- Initialization:初始化
- 这个阶段是类加载过程的最后一步。这时候,类变量将被赋值为代码里的值。
上面这段话可能说得很抽象,不好理解,我来举个例子。
String cmower = new String("沉默王二");上面这段代码使用了 new 关键字来实例化一个字符串对象,那么这时候, 就会调用 String 类的构造方法对 cmower 进行实例化。
public String(String original) {
    this.value = original.value;
    this.hash = original.hash;
}
初始化的时机:
- 创建类的实例时
- 访问类的静态方法或者静态字段时
- 使用 java.lang.reflect 包的方法对类进行反射调用时
- 初始化一个类的子类时
- JVM启动时,初始化主类
类加载器
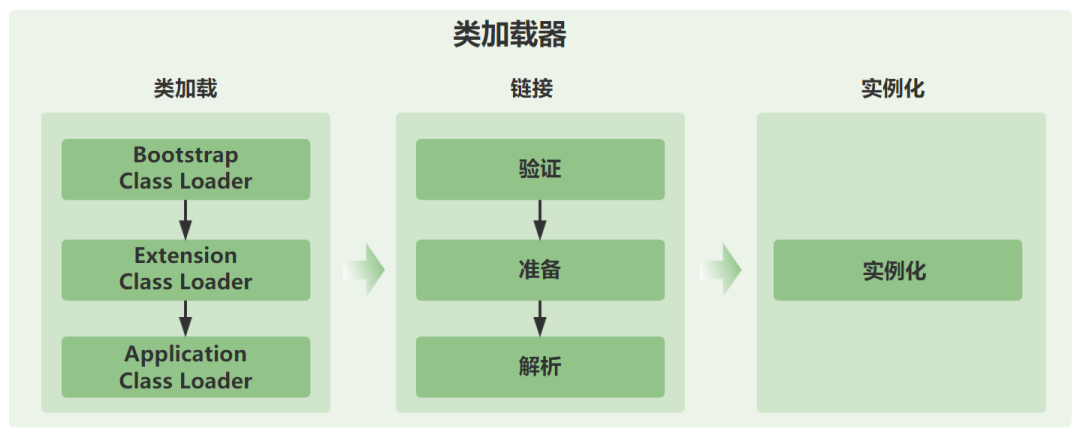
对任意一个类,都由它的类加载器和类本身一同确定其在JVM中的唯一性。如果两个类的加载器不同,即使来源于同一个字节码文件,两个类也不相等。
类加载器可以分为四个类型:
- Bootstrap ClassLoader:引导类加载器。负责加载JVM核心类库。
- Extension ClassLoader:扩展类加载器。加载Java扩展库的类。
- System ClassLoader:系统类加载器。负责加载系统类路径java.class.path上指定的类库,通常是应用类和第三方库。
- User ClassLoader:用户自定义类加载器。用户可以自己定义类加载器。
双亲委派模型
这是Java类加载器使用的一种机制,用于确保Java程序的稳定性和安全性。类加载器在尝试加载一个类时,首先会委派给父加载器去加载,失败了才会自己尝试去加载。
这个委派是递归的,父加载器又会委派它的父加载器,最后从启动类加载器开始、再到扩展类加载器、再到系统类加载器。
这样可以确保不会重复加载类,并保护Java核心API不被恶意替换。
防止重复加载:比如我自定义了一个String类。按照双亲委派模型,会先让引导类加载器尝试加载,然后它的lib/rt.jar中已经有String类了,所以不会重复加载。 保护核心API:类似同上,建立同名但是修改过的类,根据双亲委派模型会加载正版的类,子类加载器不会执行,也就不会导入。
Java类文件结构
紧跟着魔数后面的四个字节 0000 0037 分别表示副版本号和主版本号。也就是说,主版本号为 55(0x37 的十进制),也就是 Java 11 对应的版本号,副版本号为 0。
从javap角度看懂字节码
栈虚拟机和寄存器虚拟机
从硬件层面,栈位于内存中、寄存器在CPU中,这就是为什么一般情况下,基于寄存器结构的虚拟机会比基于栈的虚拟机快的原因。
HotSpot VM是基于栈的一种虚拟机,当Java程序运行时,HotSpot VM加载编译后的字节码文件,也就是.class。解释器或JIT读取字节码指令并转换成机器码。
方法调用、执行过程中的数据,会存储在栈中。
基于栈的优点是可移植性更好、指令更短、实现起来简单,但不能随机访问栈中的元素,完成相同功能所需要的指令数也比寄存器的要多,需要频繁的入栈和出栈。
基于寄存器的优点是速度快,有利于程序运行速度的优化,但操作数需要显式指定,指令也比较长。
字节码指令详解
直接skip
深入理解栈帧结构
每一个栈帧都包括了局部变量表、操作数栈、动态链接、方法返回地址和一些额外的附加信息
一个线程中的方法调用链可能很长,很多方法都处于执行状态。当前线程位于栈顶的栈帧被称为当前栈帧。
局部变量表
它用来保存方法中的局部变量,以及方法参数。当Java源代码文件被编译成class文件的时候,局部变量表的最大容量就是确定的。
操作数栈
它的最大深度也是在编译时就已经确定。
动态链接
每个栈帧都包含了一个指向运行时常量池该栈帧所属方法的引用。
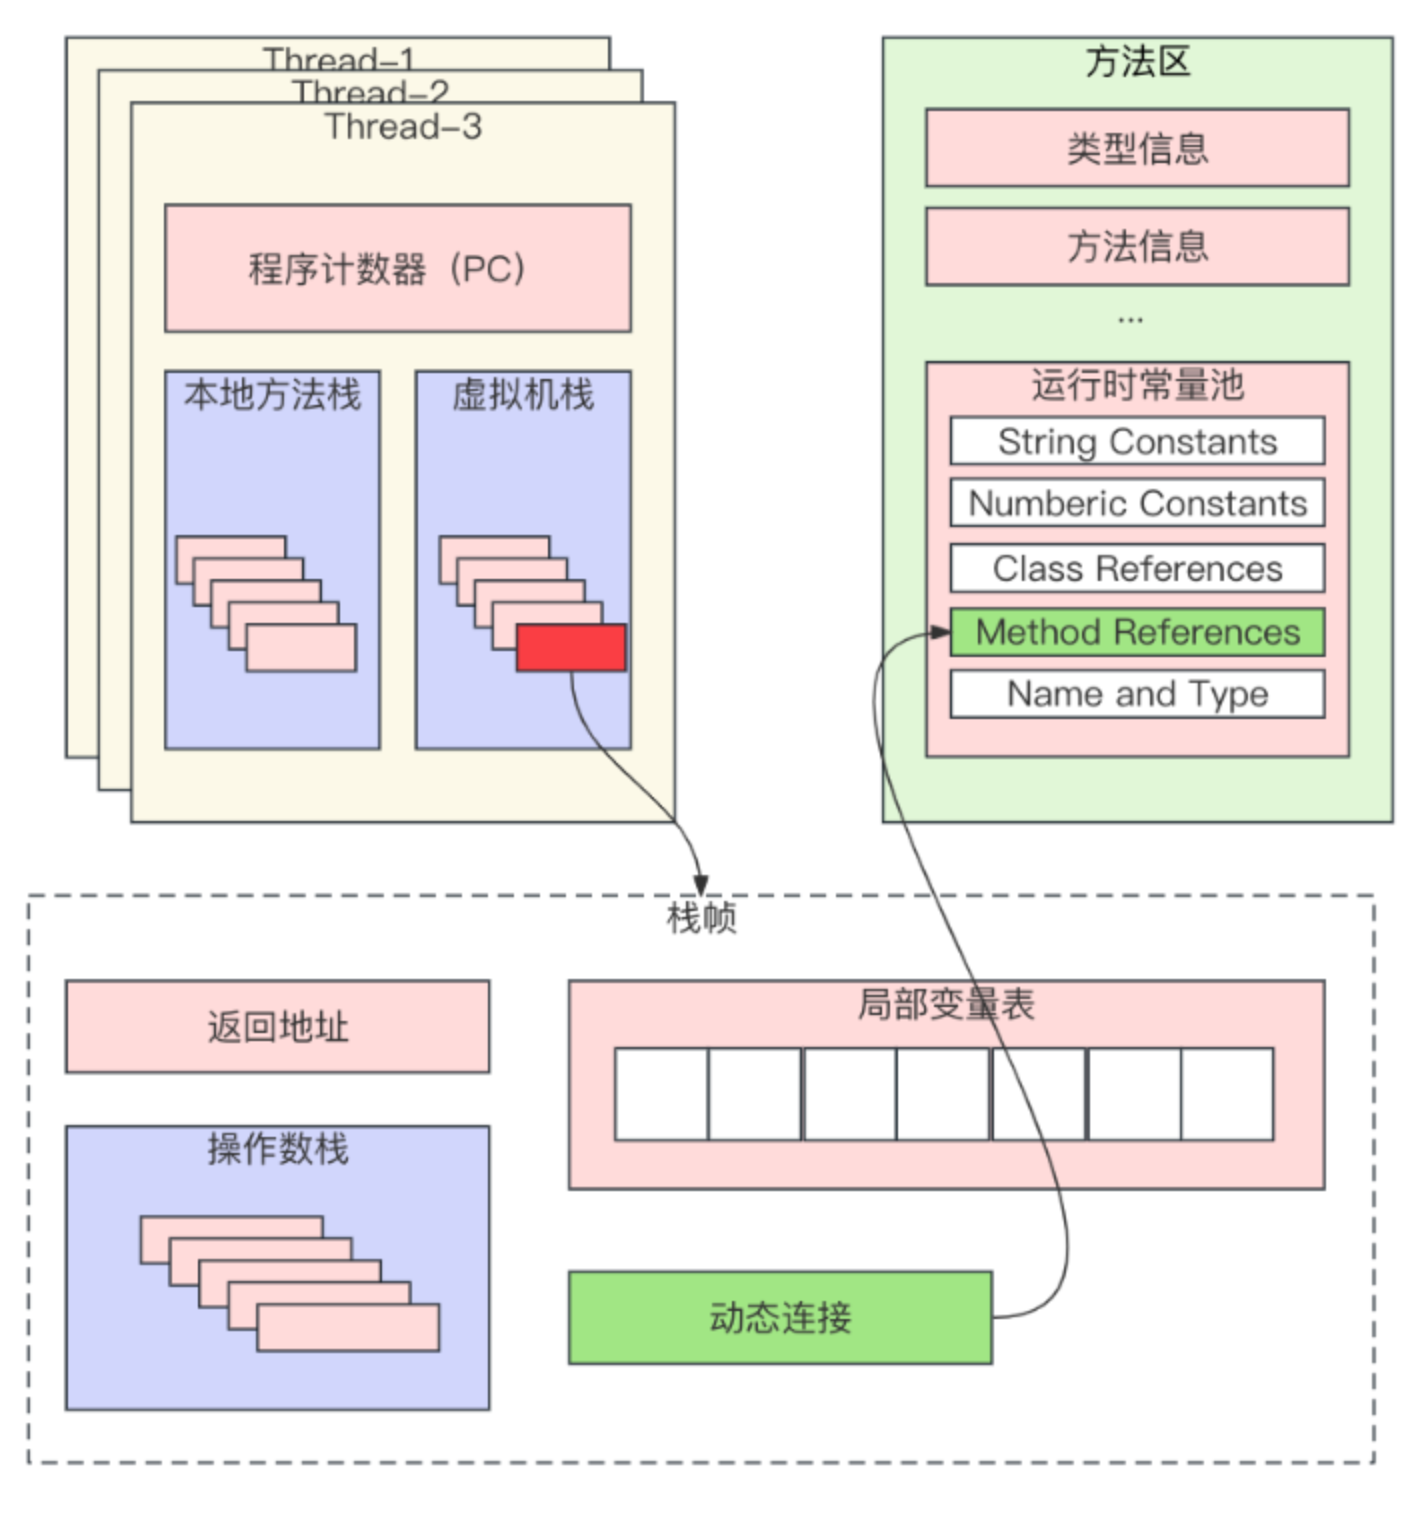
方法区是JVM的一个运行时内存区域,是逻辑定义,不同JDK可能不同。运行时常量池是方法区的一部分,用于存放编译期生成的各种字面量和符号引用,在类加载后进入运行时常量池。
深入理解运行时数据区
类加载器加载完毕后交给执行引擎执行。执行的时候JVM划分出一块空间存储程序执行期间需要用到的数据。这块数据就被称为运行时数据区。
根据Java虚拟机规定,运行时数据区分为以下几个部分:
- 程序计数器 Program Counter Register
- Java虚拟机栈 Java Virtual Machine Stack
- 本地方法栈 Native Method Stack
- 堆 Heap
- 方法区 Method Area
JDK8开始,永久代被移除,取而代之的是元空间。它不再是JVM内存的一部分,是通过本地内存实现的。
程序计数器
程序计数器占用的内存空间是不大的,每个线程私有。如果执行的是本地方法,那么程序计数器中是undefined,具体返回地址在栈帧里。 那么为什么是undefined的?因为本地方法大多是C/C++实现的,没有编译成需要执行的字节码指令。
Java虚拟机栈
上文已经讲过,主要有局部变量表、操作数栈、方法返回地址和动态链接。
本地方法栈
跟Java虚拟机栈是类似的,只不过它是执行的native方法
为什么要特别设置一个本地方法栈而不是跟Java虚拟机栈合并在一起呢?主要是为了安全性+隔离性+可维护性。毕竟本地方法属于本地,不属于JVM,单独一个栈可以类似沙箱一样的保护效果。
堆
堆是所有线程共享的一块内存区域。在JVM启动的时候创建。 以前,Java 中“几乎”所有的对象都会在堆中分配,但随着 JIT 编译器的发展和逃逸技术的逐渐成熟,所有的对象都分配到堆上渐渐变得不那么“绝对”了。从 JDK 7 开始,Java 虚拟机已经默认开启逃逸分析了,意味着如果某些方法中的对象引用没有被返回或者未被外面使用(也就是未逃逸出去),那么对象可以直接在栈上分配内存。
逃逸分析:Escape Analysis,我一种编译器优化技术,如果编译器确定一个对象不会逃逸出方法或者线程的范围,它可以选择在栈上分配这个对象,而不是在堆上。这样可以减少垃圾回收压力并提高性能。
堆除了是对象的聚集地,而且还是Java垃圾收集器管理的主要区域,因此也被叫做GC堆。堆最容易出问题的就是OutOfMemoryError,比如堆内存不足、堆内存泄漏等。
元空间和方法区
JDK7方法区被称为永久代,JDK8开始,永久代被移除,取而代之的是元空间。元空间直接利用本地内存。
深入理解垃圾回收机制
垃圾判断算法
一般是两种:引用计数算法和可达性分析算法
引用计数算法
它在对象头中分配一个空间来保存该对象被引用的次数。被其他对象引用,计数+1,反之减少。当计数为0时被回收。
引用计数算法把垃圾回收分摊到整个应用程序的运行当中,而不是集中在垃圾收集时。因此,采用引用计数的垃圾回收不属于严格意义上的“STOP-THE-WORLD”的垃圾收集机制。
引用计数法看起来很好!但是有致命缺陷:无法解决循环依赖问题。
public class ReferenceCountingGC {

    public Object instance;  // 对象属性,用于存储对另一个 ReferenceCountingGC 对象的引用

    public ReferenceCountingGC(String name) {
        // 构造方法
    }

    public static void testGC() {
        // 创建两个 ReferenceCountingGC 对象
        ReferenceCountingGC a = new ReferenceCountingGC("沉默王二");
        ReferenceCountingGC b = new ReferenceCountingGC("沉默王三");

        // 使 a 和 b 相互引用
        a.instance = b;
        b.instance = a;

        // 将 a 和 b 设置为 null
        a = null;
        b = null;

        // 这个位置是垃圾回收的触发点
    }
}
可达性分析算法
可达性分析算法的基本思路:通过GC Roots为起点,向下搜索,搜索走过的路径被称为引用链,Reference Chain。 当一个对象到GC Roots之间没有任何引用相连时,即从GC Roots到该对象节点不可达,那么这个对象是需要垃圾收集的。
通过可达性算法,就可以解决引用计数无法解决循环依赖的问题了。
GC Roots,就是一组必须活跃的引用,不是对象。Java的 GC Roots包括:
- 虚拟机栈中的引用
- 本地方法栈中JNI的引用
- 类静态变量
- 运行时常量池中的常量
垃圾收集算法
如何高效地进行垃圾回收?
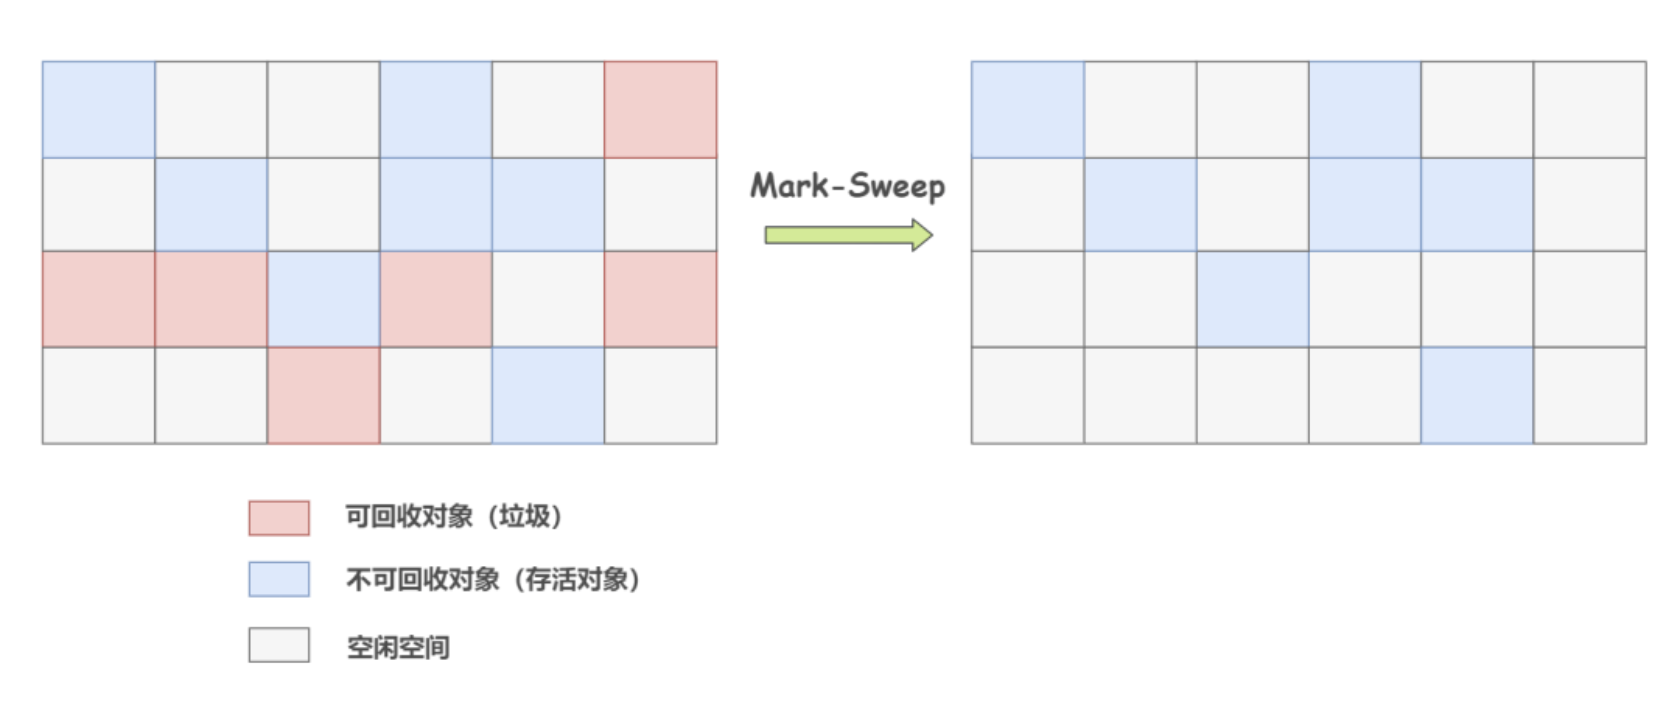
标记清除算法 最基础的一种,先把内存区域中的可回收对象进行标记,用之前的可达性分析算法。然后清理垃圾。它存在的一个很大问题是内存碎片。碎片太多会导致如果需要分配一个占内存较大的对象,而当前内存里找不到连续的一片足够大小的内存地址,就会触发新一轮的垃圾收集。
复制算法 它是在标记清除算法上演化而来。用来解决标记清除算法的垃圾回收问题。它把可用内存均分为两块,每次只使用其中一块。
当其中一块用完了。就把仍然存活的对象复制到另外一块上,并且保证复制后的对象都是紧凑排列的。然后再把之前的那片内存空间进行清理。这样就保证了内存的连续性。
但是复制算法的问题是显而易见的!就是可用内存空间岂不是变成了物理内存的一半吗?代价实在是太高了。
- 标记整理算法 标记过程跟标记清楚算法类似。但是后续不是直接对可回收对象进行处理,而是让所有存活的对象都向一端移动,再清理掉端边界以外的内存区域。
它看起来很美好!但是内存变动会更加频繁,在效率上比复制算法差很多。
- 分代收集算法 根据对象存在周期的不同 会把内存划分为几个小块。一般是把Java堆分成新生代和老年代,这样可以根据各个年代的特点采用最适当的收集算法
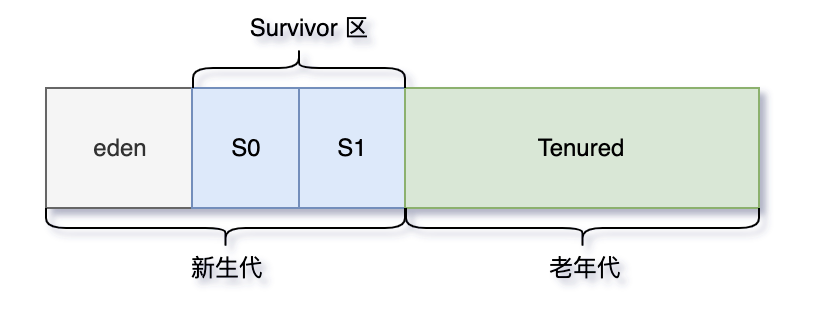
在新生代中,每次垃圾收集时都有大批对象死去,就选用复制算法,只需要付出少量存活对象的复制成本就可以完成收集。
老年代中,对象的存活率高,复制算法不合适,就使用标记清理或者标记整理进行回收。
新生代和老年代
堆是JVM中最大的一块内存区域,也是垃圾处理器管理的主要区域。
堆主要分为两个区域,新生代和老年代。新生代又分为Eden区和Survivor区。其中Survivor区又分为From和To两个区。
Eden区
根据IBM公司之前的研究表明,有将近98%的对象是朝生夕死,所以针对这一现状,大多数情况下,对象会在新生代Eden区中进行分配,当Eden区没有足够的空间进行分配时,JVM会发起一次MinorGC,MinorGC相比MajorGC更频繁,回收速度也更快。 通过MinorGC之后,Eden区内绝大部分对象会被回收。那些无需回收的存活对象,将会进入到Survivor的From区。如果From区不够,则会直接进入To区。
Survivor区
Survivor区相当于是Eden区和Old区的一个缓冲,类似交通灯的黄灯。
- 为啥需要Survivor区? 新生代到老年代为什么不直接转换?为什么要多做一个Survivor区? 如果没有Survivor区,Eden区每次Minor GC,存活的对象就会被送到老年代,老年代很快被填满,但是很多对象可能第一次没有消灭,但是第二第三次就没了。 所以Survivor区存在的意义就是减少被送到老年代的对象,进而减少Major GC的发生。Survivor保证只有经历了16次Minor GC后仍然存活的对象才会被送到老年代。
- Survivor区为什么分成两块? 是为了解决内存碎片化问题。Minor GC后,Eden区被清空,存活的对象放到Survivor区。而之前Survivor区中的对象,可能也有一些是需要被清楚的,那么这时候如何清除?
在这种场景下,我们只能够标记清除,而标记清除的最大问题就是内存碎片。
而如果Survivor有两个区域,每次Minor GC。会把之前Eden和From中存活的对象复制到To区域,第二次Minor GC时,From与To职责互换,把Eden和To区域存活的对象再复制到From区域。
这种机制最大的好处是,永远只有一个Survivor区域是空的,而另一半一定是无碎片的。
那么,Survivor 为什么不分更多块呢?比方说分成三个、四个、五个?
显然,如果 Survivor 区再细分下去,每一块的空间就会比较小,容易导致 Survivor 区满,两块 Survivor 区可能是经过权衡之后的最佳方案。
Old区
老年代占据了三分之二的堆内存空间。只有Major GC的时候才会进行清理,每次GC都会触发“STOP THE WORLD”。内存越大,STW时间就越长,所以内存不仅仅是越大越好。
由于复制算法在对象存活率较高的老年代会进行很多次复制操作。因此老年代是标记整理算法。
除了上述情况,在内存担保机制下,无法安置的对象会直接进入到老年代。以下情况也会。
- 大对象 大对象需要大量连续内存空间,这样的对象会直接进入老年代。主要是为了防止在Eden和Survivor区发生大量的内存复制。
- 长期存活对象 虚拟机给每个对象定义了一个对象年龄Age计数器,对象在Survivor区中每经历一次Minor GC,年龄就增加一岁。当年龄增加到15岁时,这时候会被转移到老年代。
- 动态对象年龄 JVM不强制对象年龄必须15岁才能到老年区,如果Su'rv'ivor空间中相同年龄所有对象大小的总和大于Survivor空间的一半,年龄大于或等于该年龄的对象就可以直接进入老年代,无需等到15岁。
深入理解JVM的垃圾收集器
工作中涉及到的调优工作也是经常围绕垃圾回收器展开。面对不同的业务场景,往往需要不同的垃圾收集器才能保证GC性能。
目前来说,JVM的垃圾收集器主要分为两大类:分代收集器和分区收集器。分代收集器的代表就是CMS,分区收集器的代表就是G1和ZGC。下面我们看看两大类垃圾收集器。
分代收集器
CMS
以获取最短回收停顿时间为目标,采用标记清除算法。分四大步进行垃圾收集,其中初始标记和重新标记会STW,JDK1.5时引入。JDK9被标记为弃用,JDK14被移除。
CMS属于分代收集器,因为它在老年代工作。也可以联想到为什么是标记清除算法。
CMS,也就是Concurrent Mark Sweep.它是第一个关注GC停顿时间(STW时间)的垃圾收集器。之前的垃圾收集器中,要么是串行的垃圾回收方式,要么只关注系统吞吐量。
CMS垃圾收集器之所以能够实时对GC停顿时间的控制,本质来源于对可达性分析算法的改进,即三色标记算法。在CMS出现之前,无论是Serious垃圾收集器、还是ParNew垃圾收集器、还是Parallel Scavenge垃圾收集器,它们在进行垃圾回收的时候都需要Stop The World.无法实现垃圾回收线程与用户线程的并发执行。
CMS垃圾收集器通过三色标记算法,实现了垃圾回收线程和用户线程的并发执行,从而极大地降低了系统的响应时间,提高强交互程序的体验。
它的运行过程分为四个步骤:
- 初始标记
- 并发标记
- 重新标记
- 并发清除
初始标记:指的是所有被GCRoots引用的对象,该阶段需要Stop the World。这个步骤只是标记一下GC Roots能直接关联到的对象。并不需要做整个引用的扫描,因此速度很快。
并发标记:对之前初始标记的对象进行整个引用链的扫描,不需要STW。因为是遍历整个引用链,时间很长,因此是并行执行,降低垃圾回收的时间。
这是CMS能极大降低GC停顿时间的核心原因。但是有问题:并发标记的时候,引用可能发生变化,可能会发生漏标和多标的情况。
重新标记:指的是对并发标记出现的漏标、多标情况进行矫正。那么这个阶段肯定是要STW的,不然无法解决再次漏标多标问题。
并发清除:把之前被标记为垃圾的对象进行清除。不需要STW。
CMS的优点是:并发收集、低停顿,但是缺点也很明显:
- 对CPU资源敏感。因为并发标记和并发清除是跟用户线程并发执行的。
- CMS采用的是标记清除算法,会有大量的内存碎片。
- CMS无法处理浮动垃圾。在CMS在垃圾回收的时候,应用程序还在不断地产生垃圾,这些只能在下一次GC时清理掉
分区收集器
G1
G1(Garbage-First)在JDK1.7的时候引入,在JDK9时取代了CMS成为默认垃圾收集器。G1有五个属性:分代、增量、并行、标记整理、STW。
分代:它把堆内存分成多个大小相等的区域,每个区域都能是Eden区、Survivor区和Old区。 G1 有专门分配大对象的 Region 叫 Humongous 区,而不是让大对象直接进入老年代的 Region 中。在 G1 中,大对象的判定规则就是一个大对象超过了一个 Region 大小的 50%,比如每个 Region 是 2M,只要一个对象超过了 1M,就会被放入 Humongous 中,而且一个大对象如果太大,可能会横跨多个 Region 来存放。
增量:G1可以以增量的方式进行垃圾回收,意味着不需要一次性回收整个堆空间,而是可以逐步、增量地清理。有助于控制停顿时间。
并行:G1在垃圾回收时,可以并行执行,提高垃圾回收的效率。
标记整理:G1采用标记整理算法,可以避免内存碎片的问题。而对于年轻代,用复制算法。
G1也基于标记清除算法、需要STW,G1存在三种GC模式、分别是Young GC、Mixed GC和Full GC。
当Eden区的内存空间无法支持新对象的内存时分配时,G1会触发Young GC。
当需要分配对象到Humongous区或者堆内存空间超过一定值,G1会触发一次concurrent marking。作用是计算老年代中多少空间需要被回收。垃圾占比超过一定值,下次young GC后会触发一次Mixed GC。
Mixed GC是指的回收年轻代的Region以及一部分老年代中的Region。Mixed GC和Young GC一样,也是复制算法。
G1有特殊的停顿预测模型,Pause Prediction Model,用来预测停顿时间。
ZGC
JDK11推出的低延迟垃圾收集器。Z是Zetta byte的意思。
Java创建的对象放在哪?新生代还是老年代?
对象优先在Eden分配。随着对象不断创建,Eden区域越来越少,随后触发Minor GC,于是JVM会把Eden区剩余存活的对象放入FromSurvivor区域。
随后Eden剩余空间又少,继续Minor GC,然后同上,但是是把From Survivor的对象复制到To Survivor里面。之前讲过了,是复制算法。
针对大对象,如果一直在Survivor里面复制来复制去,耗费性能,大对象直接进入老年代。
这种策略是减少垃圾回收的复制开销。复制大对象更耗时。
深入理解JIT
先上一张图
怎么样被认为是热点代码?方法或者代码在一定时间内的调用次数超过一定阈值,就会被认定为热点代码。然后编译存入codeCache中。下次执行就直接从缓存读取机器码。
JVM集成了两种编译器。一种是Client Compiler,另一种是Server Compiler。 客户端编译器注重启动速度和局部优化,服务端更加关注全局的优化,性能更好,但是启动速度慢。
内存溢出排查优化实战。
内存溢出和内存泄露
在Java中,和内存相关的问题主要有两种,内存溢出和内存泄漏。
- 内存溢出(Out Of Memory):申请内存时,JVM通常没有足够的内存空间。
- 内存泄漏(Memory Leak):申请的内存空间没有被正确释放,导致内存空间浪费。
内存溢出
在JVM的内存区域中,除了程序计数器、其他内存区域都有可能发生内存溢出。
内存泄漏
内存泄漏是已动态分配的堆内存由于某种原因未能释放或者无法释放、造成系统内存的浪费。